实时交互
MOSS-Live 让 AI 能够在同一场对话中持续倾听、自然交流,并同步处理任务。它在说话时也能理解新的输入,根据语义判断何时接话、何时等待、何时接受打断;在多轮交流与话题切换之后,仍能跟踪前文,接续尚未讲完的内容。
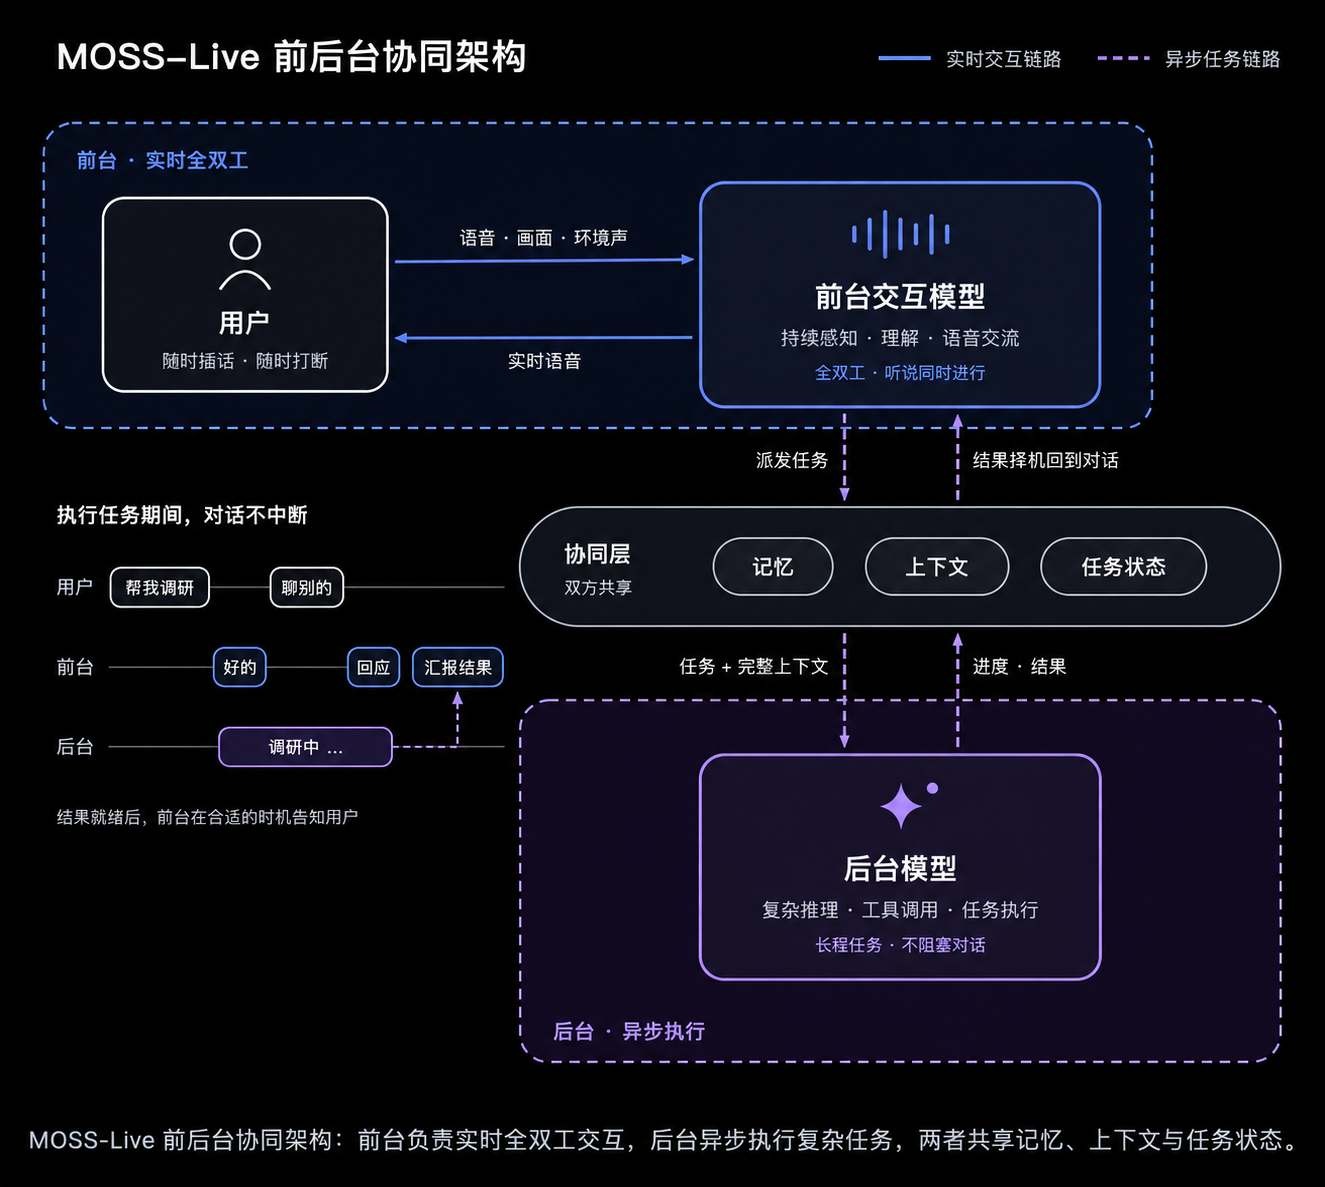
系统将语音、实时视频、屏幕共享与环境声音结合起来,并通过前后台协同架构,将复杂推理、工具调用和任务执行交给后台异步处理。用户可以一边交流、一边交办任务,结果就绪后,MOSS-Live 会选择合适的时机带回对话。
核心能力
全双工对话与语义打断
听和说可以同时进行。MOSS-Live 根据语义与上下文区分附和、思考停顿和真正的打断:用户随口说“嗯”“对”时继续表达,用户提出新问题时及时停下,并转向新的需求。
无关声音拒识与多人交互
在多人交谈、车载导航或背景语音出现时,判断声音是否指向自己,减少无关语音造成的误接话。在多人讨论中持续跟踪话题、发言对象和信息变化。
多轮记忆与打断后接续
对话中可以随时插入问题、补充条件或切换话题。MOSS-Live 持续维护上下文,在用户回到原来的话题时,接着之前中断的位置继续交流。
实时视听理解
支持视频通话与屏幕共享,将画面内容、语音和环境声音用于当前对话。用户可以对着真实场景提问,让 MOSS-Live 结合眼前的信息进行理解、讲解与查询。
工具调用与后台异步执行
支持在交流过程中查询信息、规划行程和开展调研。需要较长时间的任务在后台执行,前台继续对话;任务进度与结果通过共享上下文同步,并在合适的时机反馈给用户。
流式同声传译与主动交互
在持续接收源语言语音的同时输出目标语言,无需等待整段发言结束。也支持按照用户设定的条件主动介入,例如在背诵出现错误时纠正,或在会议讨论满足特定条件时提醒。
技术架构
MOSS-Live 将实时交互与复杂任务处理分工协作,让长时间运行的任务与当前对话并行推进。
- 前台交互模型:持续感知语音、画面与环境信息,负责理解、语音交流以及接话、等待和打断判断。
- 后台模型:承担复杂推理、工具调用与任务执行,异步处理前台交付的任务及相关上下文。
- 协同层:共享记忆、上下文与任务状态,让前台了解后台进度,并将结果自然带回对话。
Demo 展示
Demo 1|多人会议:参与讨论,查询信息,整理结论
在一场活动筹备会议中,MOSS-Live 作为 AI 参会者,根据讨论内容查询上海、杭州的天气与同期活动。查询期间讨论继续进行,结果就绪后择机汇报;面对附和继续发言,遇到新问题则及时停下。几轮讨论后,它仍能接续先前话题,并整理初步结论与后续待办。
展示能力:多人交互、附和与打断区分、上下文记忆、工具调用、主动反馈。
Demo 2|自驾游规划:随时改需求,行程继续推进
用户规划舟山两日游时,临时把偏好从爬山改为海边放松,又陆续插入船票、停车费用和住宿问题。MOSS-Live 一边调整行程、一边在后台查询酒店;用户说“接着刚刚的岛上规划说”时,它能够回到原来的介绍,同时避免把车载导航提示当成新的用户指令。
展示能力:多轮需求更新、打断后接续、后台任务、无关声音拒识。
Demo 3|上海旅行:边看边聊,理解眼前的世界
外国游客通过手机与 MOSS-Live 交流,规划经过外滩和南京路的游览路线。游客举起手机询问建筑时,MOSS-Live 结合实时画面识别和平饭店并介绍历史;话题转向房价与餐饮后,它继续查询相关信息,随后还能接回尚未讲完的绿色屋顶故事。
展示能力:英语对话、实时画面理解、信息查询、附和识别、上下文接续。
评测结果
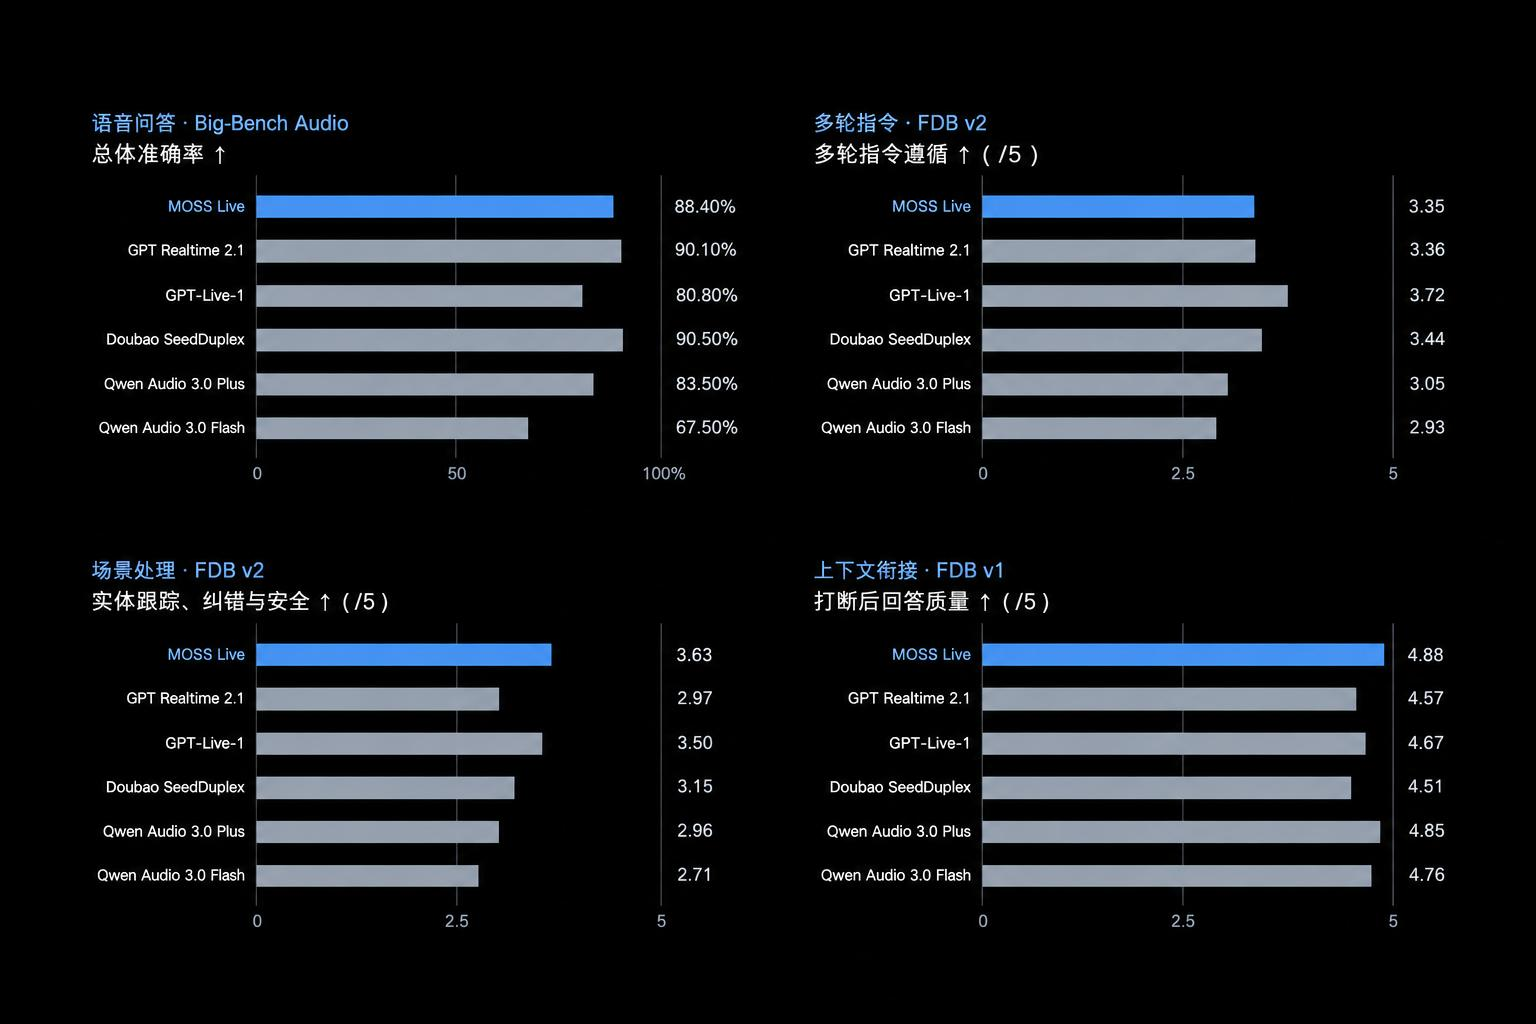
围绕全双工交互、工具调用、语音理解与多轮对话,我们汇总了 FDB v1、FDB v1.5、FDB v2、FDB v3、Big-Bench Audio 和 τ-Voice 六个基准的评测结果,并与多款语音模型进行了对比。
全双工能力
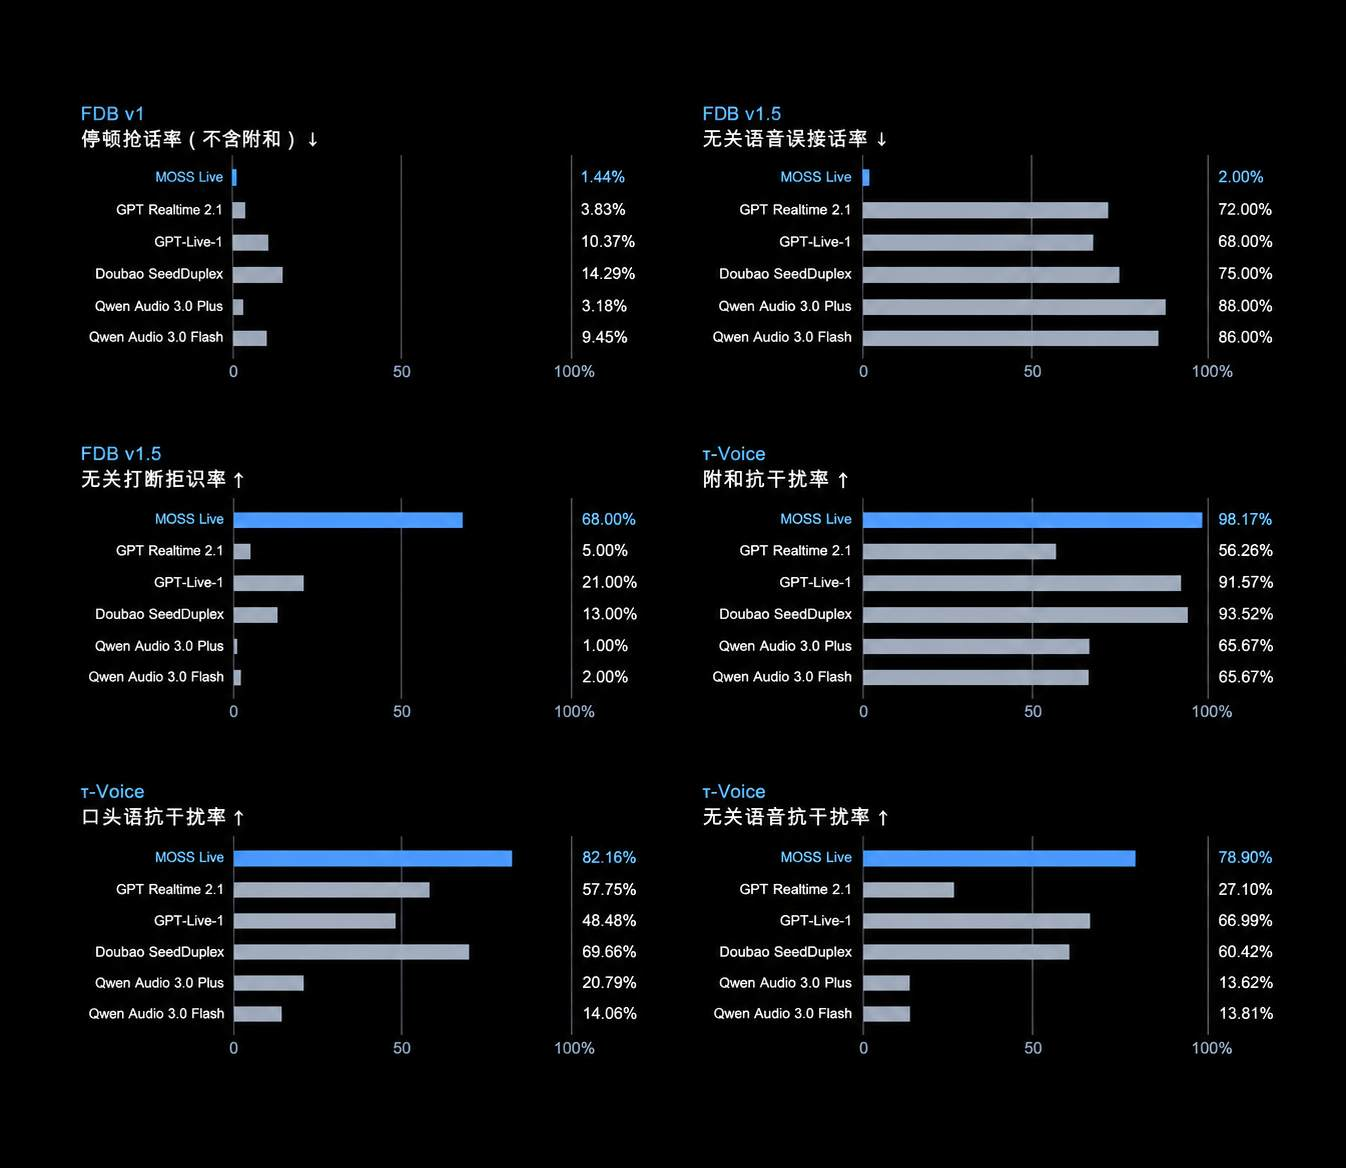
在本次汇总结果中,下图展示的六项全双工指标均位居参评模型首位。MOSS-Live 能够更好地区分短暂停顿、附和和无关语音,在保持交流连贯的同时,减少不必要的抢话与误接话。
工具调用与多轮任务
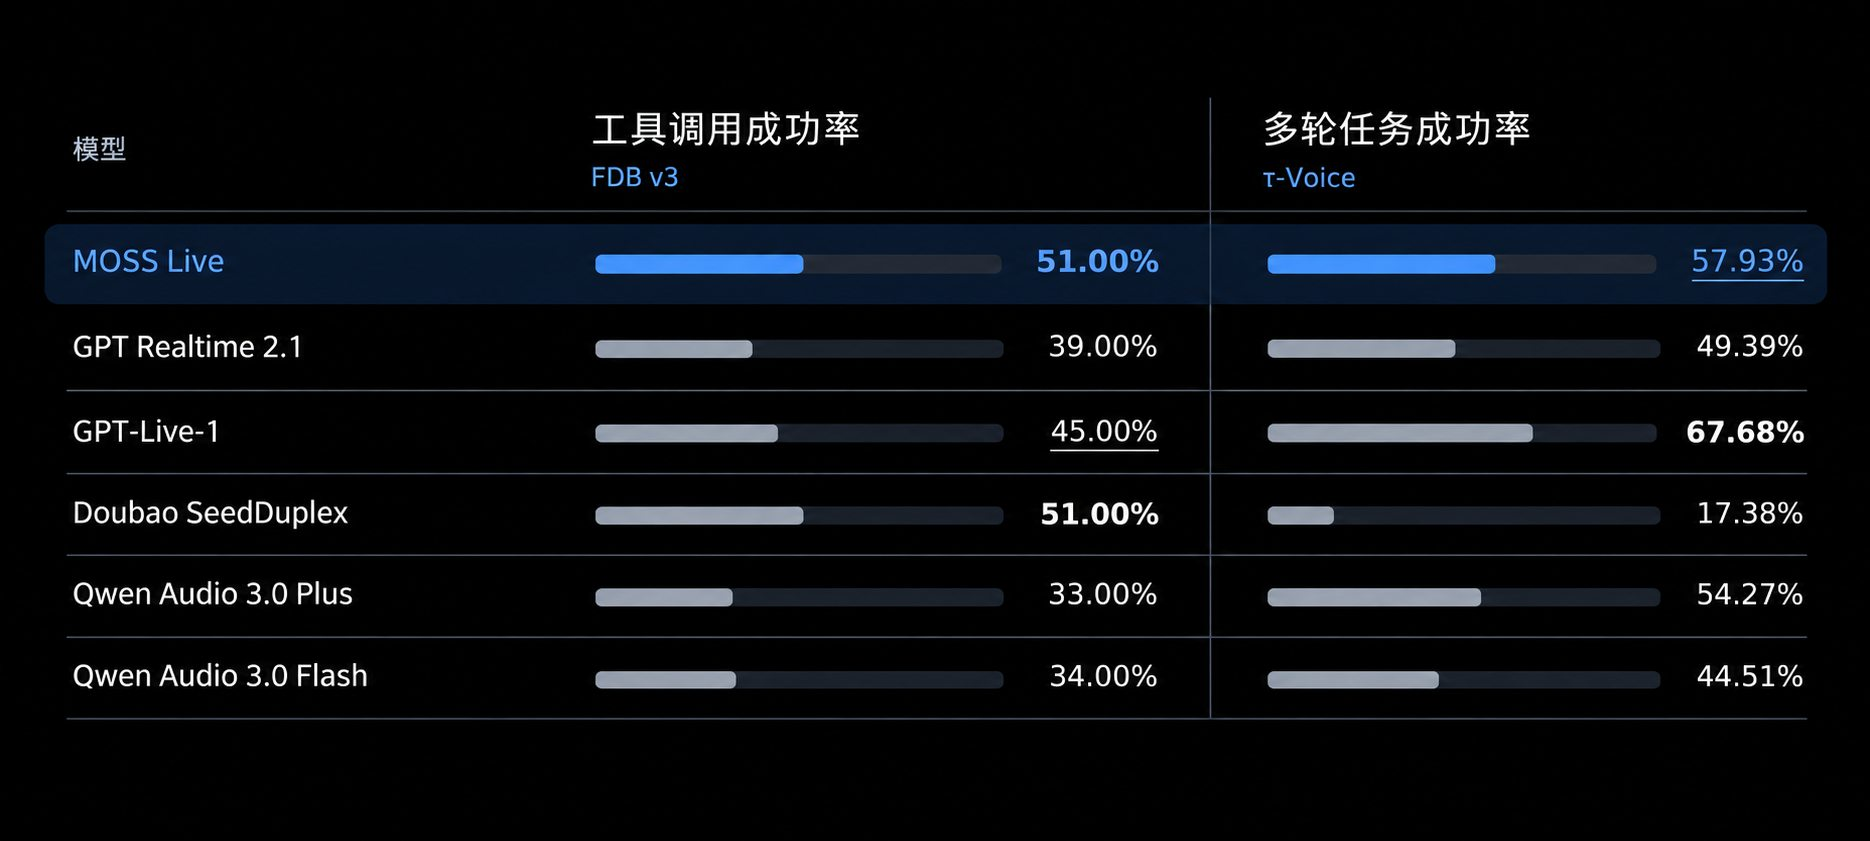
从单次工具调用到多轮任务推进,MOSS-Live 在两项评测中均位居前列:FDB v3 工具调用成功率为 51%,并列最高;τ-Voice 多轮任务成功率为 57.93%,位列参评模型第二。
语音理解与多轮对话
从语音理解到多轮对话,MOSS-Live 在本次对比的多项评测中位居前列,尤其在对话衔接、信息跟踪与纠错等方面表现突出。这些能力共同支撑着持续交流:既能听懂当前的问题,也能接住前文、跟上对话中的变化。